

セキュアなオンプレミスS3データレイクでデータ分析を推進
データ分析は洞察をもたらし、データセットが大きければ大きいほど、分析の成果も豊かになります。しかし、大量のデータを保存することには、大きな課題があります。コスト、複雑性、スケーラビリティ、そしてデータ保護です。情報から効率的に洞察を得るには、手頃で、高いスケーラビリティを持ち、使いやすく、信頼性があり、既存のツールと互換性のあるストレージが必要です。
企業の分析インフラストラクチャを、データレイクハウスに近代化しましょう。これは、クラウドのデータ分析アーキテクチャです。S3データレイクの柔軟性、コスト効率、スケールと、データウェアハウスのデータ管理、ACIDトランザクションを組み合わせることで実現します。Cloudian HyperStoreは、オープンスタンダードに基づいて構築された、費用対効果の高いオンプレミスのS3データプラットフォームを提供し、クラウドのデータレイクハウスのコンセプトをオンプレミス展開に取り入れ、真のハイブリッド体験を可能にします。
このワンページガイドを入手して、「Cloudian S3データレイクハウスでデータ分析を実行する7つの理由」を理解しましょう。
利点
- ストレージと独立して計算リソースをスケール
- 主要なデータウェアハウスプラットフォームとの標準に基づいた統合
- 最小ブロックサイズの要件なし
- レプリカでパフォーマンスを向上
- イレイジャーコーディングでデータストレージのフットプリントを削減
- データの形式を変えずにバックエンドでデータを圧縮
- 分析以外にもデータ保護、コラボレーション、災害復旧といった用途を可能にするため、サイトや地域を跨いだレプリケーションでサイロを打破
データ分析のための最新ストレージアーキテクチャとは?
現代のデータ分析ストレージアーキテクチャは、クラウドアーキテクチャに従っています。計算とストレージの要件を分離し、すべての分析データストレージニーズに対して経済的でスケーラブルなS3オブジェクトストレージを使用します。このS3データレイクを使用すると、大規模なデータセットを収集して管理し、リアルタイムのデータ分析を実行し、実際のビジネス価値を生み出す洞察を得ることができます。
通常、データレイクは、コストが低いため、ハードディスクドライブで構成されます。しかし、フラッシュストレージはそのコストの減少とパフォーマンス向上によって人気を得ています。フラッシュを使用する場合、システムは純粋にフラッシュメディア上に構築されるか、フラッシュとディスクストレージのハイブリッド構成で構築されることができます。
これらのデータレイクは、大量の構造化および非構造化データを保存することができます。そのため、ストレージ層は通常、S3 APIを標準の通信手段とするオブジェクトストレージで構築されます。これらのストレージタイプは特定の容量に制限されず、通常のボリュームはテラバイトやペタバイト規模にスケールします。
データ分析ストレージの課題
データ分析ストレージを構成および実装する際に、直面する可能性のある一般的な課題がいくつかあります。これらの課題は、パブリッククラウドでの実行とオンプレミスストレージでの実行時に異なる形をとります。
| 課題 | クラウド vs. オンプレミス |
| サイズとストレージコスト データは幾何級数的に増加し、かなりのストレージスペースを必要とします。データソースが追加されると、これらの要件がさらに増加し、それに対応する必要があります。データ分析ストレージを実装する際、データ収集と同じ速度でスケールできることを確認する必要があります。 | パブリッククラウドストレージサービスはシンプルさと耐久性を提供します。しかし、ストレージはGB/月単位で価格がつけられており、データ処理やネットワーク送信の追加料金が発生します。オンプレミスでデータ分析を行うことで、これらの大きな継続的なコストを排除し、大幅なコスト削減を実現できます。 |
| データ転送レート 大量のデータを転送する必要がある場合、高速な転送レートは鍵となります。データ分析環境では、データサイエンティストはデータを迅速にプライマリーソースから分析環境に移動できる必要があります。 | パブリッククラウドリソースは、この要求にあまり適していない場合があります。オンプレミスでは、高速LANネットワーク接続を利用するか、データを保存するマシンにストレージを直接接続することも可能です。 |
| セキュリティ データにはしばしば個人を特定可能な情報(PII)や財務データなどの機密データが含まれています。これにより、このデータは犯罪者の主な標的となり、保護されていないまま放置すると責任を伴う対象となります。意図的ではないデータの破損でさえ、重大な影響を及ぼす可能性があります。 | データが十分に保護されていることを確保するために、データストレージシステムは暗号化とアクセス制御メカニズムを使用する必要があります。システムはまた、データのコンプライアンス要件を満たす能力を備えている必要があります。一般的に、オンプレミスやプライベートクラウドでは、パブリッククラウドよりもデータセキュリティをよりコントロールすることができます。 |
| 高可用性 使用するリソースに関係なく、データが高可用性を維持することを確保する必要があります。インフラストラクチャの障害に対処するための対策を講じる必要があります。また、アーカイブされたデータを確実かつ効率的に取得できることを確認する必要があります。 | パブリッククラウドにはこの要件を強力にサポートする能力があります。オンプレミスで実行する場合は、データストレージソリューションがクラスターリングとストレージユニットのレプリケーションをサポートしており、クラウドストレージサービスに匹敵する冗長性と高耐久性を提供していることを確認してください。 |
スイスの主要金融機関が、データ分析用にCloudianデータプラットフォームをS3データレイクとして展開
データ分析ストレージの重要な考慮事項
データ分析ストレージソリューションを実装する際には、考慮すべきベストプラクティスがいくつかあります。

要件を定義
データのインベントリと分類から始めます。アクセス頻度、レイテンシー許容度、コンプライアンス制限を考慮に入れます。

データティアリングを使用
低耐久性、低パフォーマンス、またはアクセス頻度が少ない場合に、低コストのデータ階層にデータを移動できるようにするストレージソリューションを使用します。

データ保護 & 災害復旧
データのバックアップと復元のポリシーを設定し、ストレージ技術が目標復旧時間(RTO)や目標復旧ポイント(RPO)を満たしていることを確認します。
ユースケース
CloudianとSnowflakeの組み合わせは、データをパブリッククラウドに移動することなく、その場で分析アプリケーションを実行したいという顧客の増加する関心に対応します。初めから完全にS3互換で設計されたHyperStoreは、組織のデータセンターでプライベートクラウドとして、またはハイブリッドクラウド戦略の一環としてデプロイでき、データがパブリッククラウドサービスプロバイダーにレプリケートまたはティアリングされます。Cloudian S3互換ストレージを使用したオンプレミスのSnowflake環境を提供します。

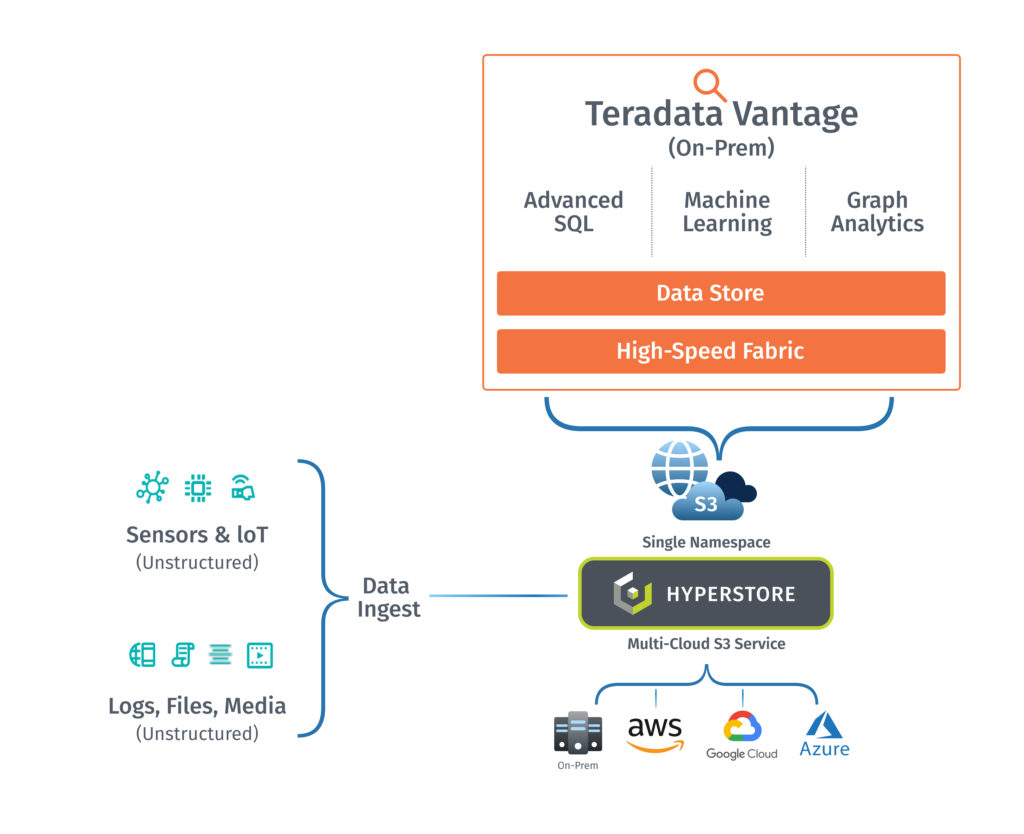

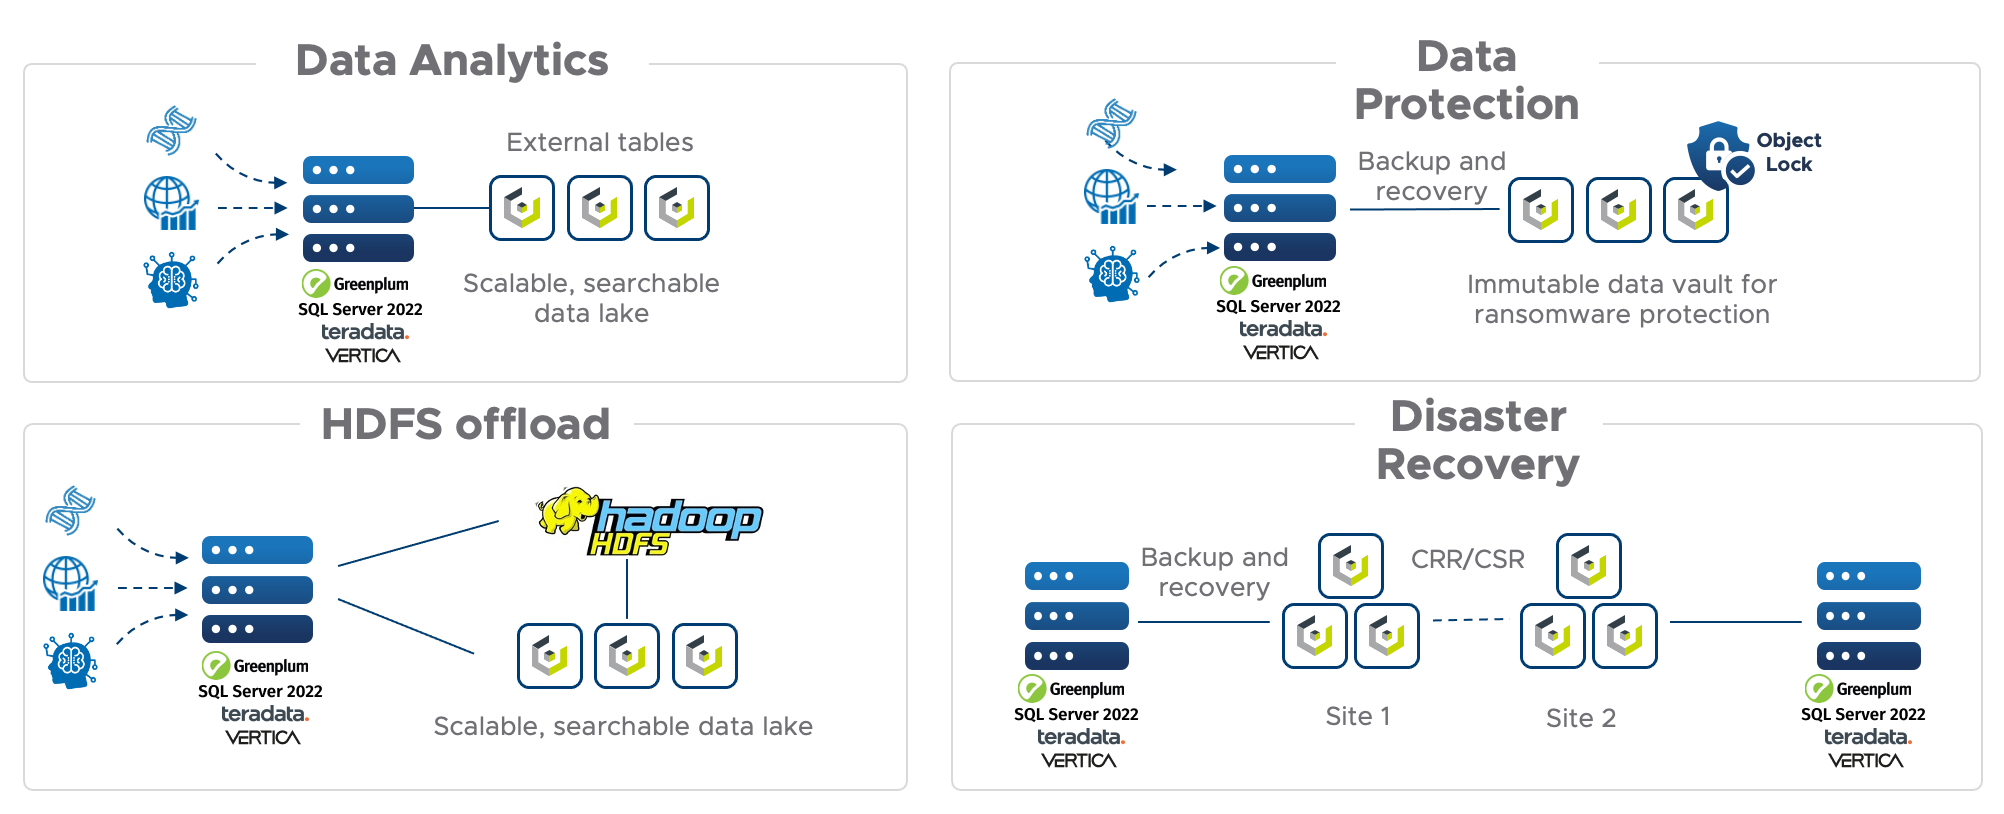
TeradataのVantageプラットフォームは、エンタープライズ分析のための接続されたマルチクラウドデータプラットフォームであり、顧客が任意のツール、言語、そしてすべてのデータを使用して重要な答えをもたらすことを可能にします。Vantageは、組織内のあらゆるタイプのデータを統合し、CloudianのHyperStoreと直接統合してデータを保存します。S3 APIをネイティブサポートしているため、VantageとHyperStoreは、HyperStoreデータレイクハウス内に直接保存されたデータを接続して分析することができ、クラウドデータウェアハウスアーキテクチャの能力をオンプレミスに持ち込むことができます。これは、分析場でのみ可能な迅速な洞察を提供します。

このVMware認定ソリューションは、新たな効率性と節約を可能にし、複雑なエンタープライズアプリケーションのための高度な分析モデルの作成と展開に最適です。オープンスタンダードに基づいて構築された手頃で管理可能、かつスケーラブルなソリューションで分析インフラストラクチャをクラウド化し、ペタバイトまでの拡張とオンデマンドでのスケールを可能にします。
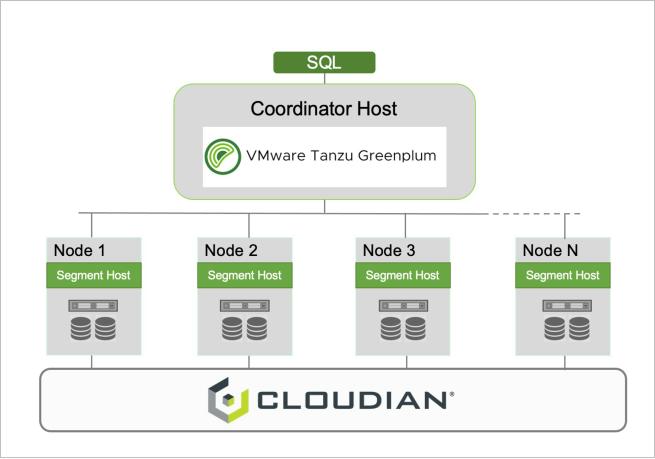


VerticaのEonモードでは、Cloudian HyperStoreオブジェクトストレージと統合し、すべてのデータを保存するS3データレイクを形成します。計算スケールとストレージスケールの分離により、顧客は必要に応じて計算ノードまたはHyperStoreノードの数を柔軟かつ独立して変更することができます。

Microsoft SQL Server 2022は、オンプレミスでクラウドデータウェアハウスアーキテクチャを使用する能力を導入しました。Cloudian HyperStoreは、HyperStoreで構築されたS3データレイクからデータを直接取り込む外部テーブルのSQL Serverワークロードを実行するために完全に検証されており、ネイティブSQL Serverテーブルをバックアップしてデータ保護を行うためのソリューションも提供します。

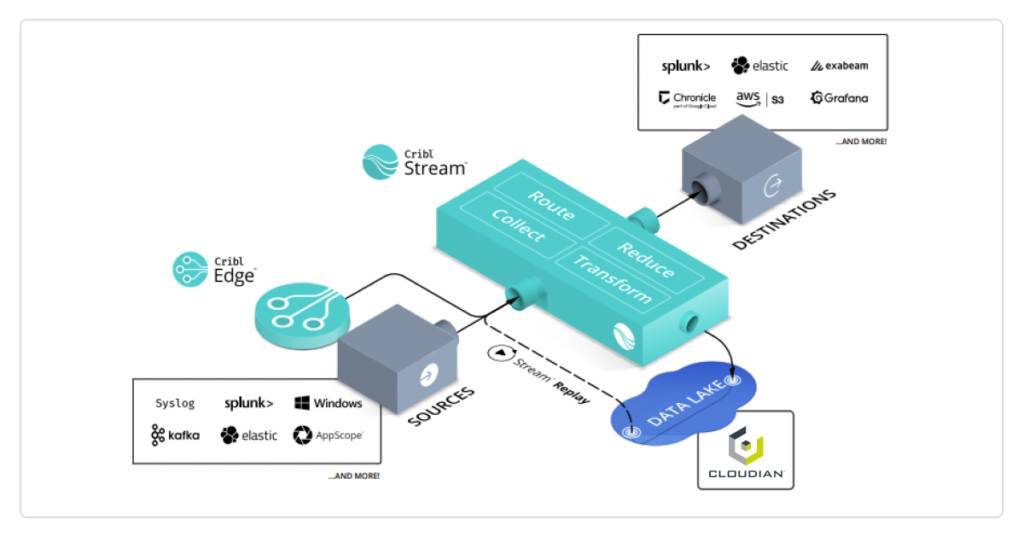

Cribl Streamは、あらゆるソースからデータを収集し、Cloudian HyperStoreにデータを送り返したりリプレイしたりできるオブザーバビリティパイプラインです。HyperStoreは、大量のさまざまなデータを管理するために設計されたスケールアウトS3データプラットフォームであり、現代のオブザーバビリティプラットフォームを形成します。
CriblとCloudianを使用して構築されたデータレイクソリューションは、データが飛んでいる間にパース、再構築、豊かにし、必要な場所に、必要な形式で正しいデータを得ることを確実にします。
Cloudian® HyperStore®とSplunk SmartStoreは、データストレージコストを60%削減しながらストレージスケーラビリティを向上させます。一緒になって、Splunkインデクサーから分離されたエクサバイトスケーラブルなストレージプールを提供します。
SmartStoreでは、Splunkインデクサーは新たにインデックスされたデータを含むホットバケット内にのみデータを保持します。古いデータはウォームバケットにあり、スケーラブルで非常にコスト効果の高いCloudianクラスター内に格納されます。
Splunkのストレージコストを60%削減し、スケーラビリティをエクサバイトに引き上げる

ソリューションスポットライト
Elasticsearch環境のデータ保護

Elasticsearchのバックアップとデータ保護
オープンソースのインデックス作成および検索プラットフォームであるElasticsearchは、あらゆる規模の企業によって使用され、データをインデックス化、検索、分析して、データ駆動型ビジネス決定に役立つ貴重な洞察を得ます。これらの貴重な洞察と共にデータ資産の耐久性を確保することは、コンプライアンスやアーカイブからビジネスの継続的な成功に至る理由で企業にとって重要です。
性能、スケール、経済性のためにデータ分析環境を最適化
より多くのユーザーにより多くのデータを提供するためにデータの洞察、管理、および保護を改善します
Clouderaのエンタープライズデータハブ(EDH)とCloudianのペタバイトスケーラブルなオブジェクトベースストレージプラットフォームを組み合わせることで、無制限のデータを複数のフレームワークで保存およびアクセス可能な完全なエンドツーエンドアプローチを提供します。
ソリューションスポットライト
CloudianとClouderaでデータ分析をスマートに
